一部枱頭機,而家裝得落一個三千億參數嘅模型。裝得落,唔等於行得順
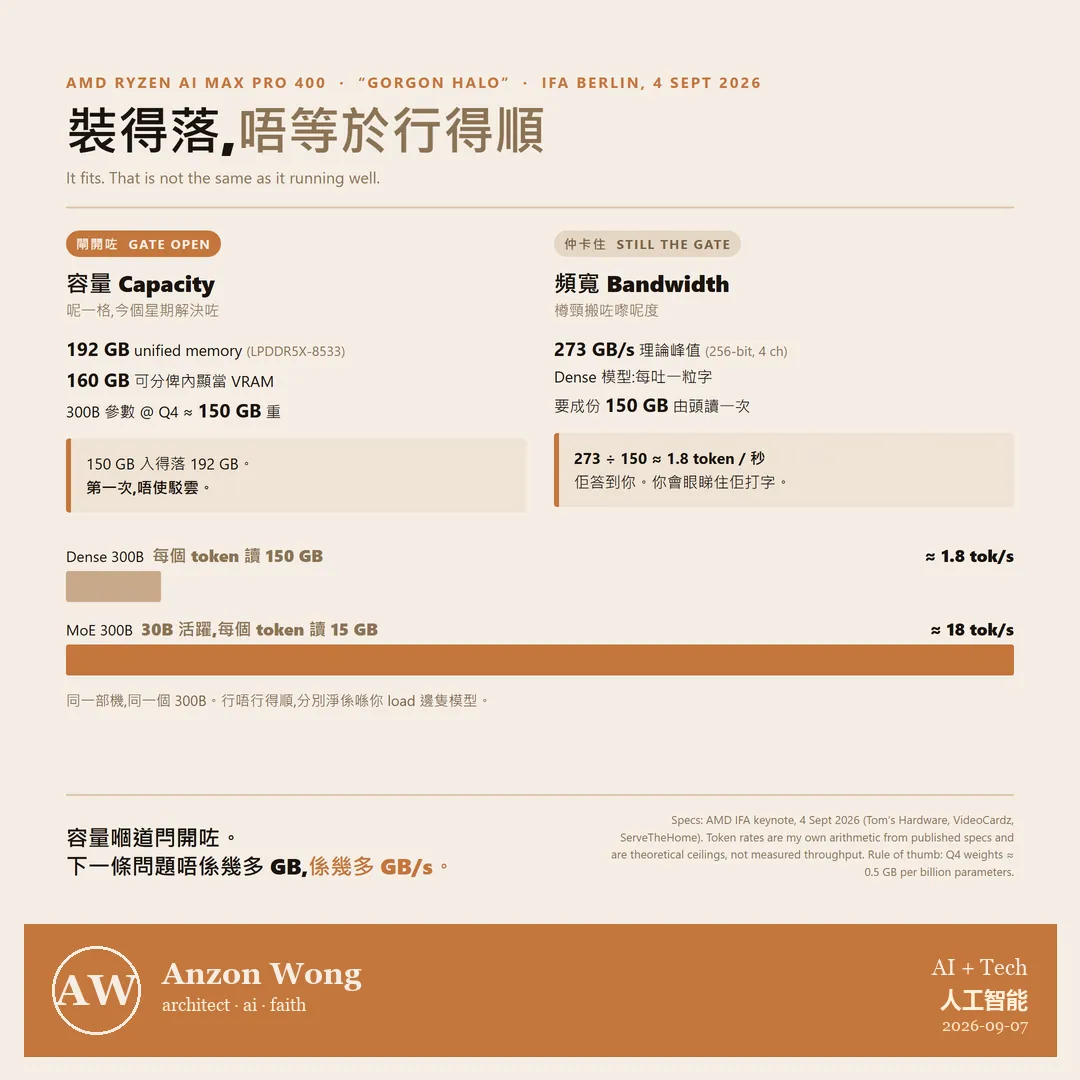
上星期五 AMD 喺柏林 IFA 開幕主題演講出咗 Ryzen AI Max PRO 400,代號 Gorgon Halo。賣點就係一個數字:192GB unified memory,CPU 同 GPU 共用同一潭記憶體,其中最多 160GB 可以分俾內顯當 VRAM 用。AMD 嘅講法係,呢個容量夠喺一部機入面行超過三千億參數嘅模型,唔使駁去雲度。HP 同 Lenovo 係首批機,第三季出貨。
呢件事對我唔算新聞,係一條我計咗成年嘅數。
我一直想喺屋企擺一部真係頂得住嘅本地 AI。原因唔係想玩新嘢,係我返工掂到嘅嘢有保密責任,有啲資料我唔想佢離開過部機。而過去一年,每次計出嚟嘅答案都一樣:裝得落大模型嗰種機,唔係一部枱頭機,係一部貴到我要諗好耐先撳得落去嘅工作站;唔係嘅話,就要收貨用細好多嘅模型。容量,一直係嗰道閂。
我一直想喺屋企擺一部真係頂得住嘅本地 AI。
今個星期,閂開咗一半。另一半我覺得都要講埋。
Q4 量化之後,大約每十億參數食半 GB,三千億即係大概 150GB 重。呢部機四通道 LPDDR5X-8533,理論頻寬大約每秒 273GB。密集模型每吐一粒字,就要成份 150GB 由頭讀一次。273 ÷ 150,大約每秒 1.8 個 token,而且係理論上限,實際只會更低。即係佢真係答到你,但你會眼睇住佢一粒字一粒字砌出嚟。
如果係 MoE 就唔同,譬如三千億入面每次只活躍三百億,同一條數就變成每秒十幾個 token,咁就真係用得。所以「行到 300B」呢句冇講大,但行唔行得順,係睇你行邊隻模型,唔係睇個標題。
我拎走嘅係:過去幾年,「我部機夠唔夠大」一直係唯一嗰條問題。而家容量呢一格解決緊,樽頸就搬咗去頻寬嗰邊。下一代要問嘅,已經唔係幾多 GB,係幾多 GB/s。
不過講到尾,我等呢部機,從來都唔係為咗快。快嘅嘢,雲上面一直都有,而且平。我等嘅係:條網線拔咗,佢照行。