AI-101 Day 45:Reasoning 模型
Day 34 講過 chain-of-thought:你喺 prompt 度加一句「一步步諗」,佢數學就叻咗。
今日講嘅嘢表面似,實際係另一回事。
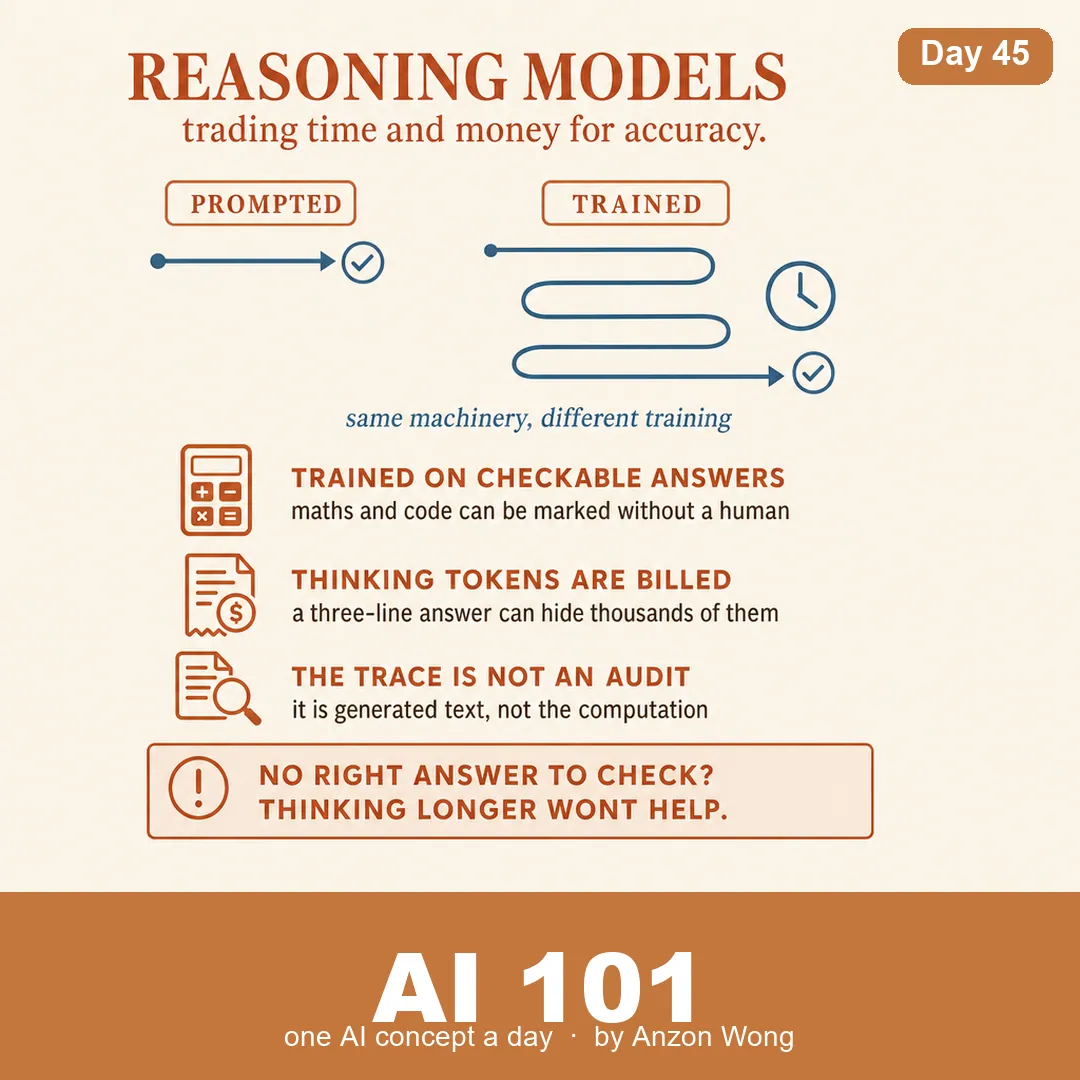
🧠 分別喺:以前係你叫佢諗,而家係佢被訓練成要諗
Reasoning 模型喺答你之前,會自己先生成一大段中間過程⋯試、否定、回頭、再試。你見到嗰個「thinking」就係佢。
但要講清楚一件事:入面冇一個「推理引擎」。 嗰段思考同佢平時吐字係完全同一部機器,一個 token 一個 token 咁出。分別唔喺機制,喺訓練。
🎯 點樣訓練出嚟?靠「答案 check 得到」
呢個先係關鍵。
數學題有標準答案。程式跑得過就係跑得過。呢啲叫可驗證嘅結果⋯機器自己就對得到,唔使人評分。
於是可以用強化學習:俾佢諗,諗完睇答案啱唔啱,啱嘅就加強嗰種諗法。做幾百萬次,佢就學識咗「乜嘢諗法會通向正確答案」。
⏱ 由此帶出一個新軸:test-time compute
以前想個模型叻啲,你要訓練大啲。而家多咗一條路:答嗰陣俾佢諗耐啲。
呢個係一個可以你自己扭嘅掣⋯thinking budget、effort level 嗰啲。同一個模型,俾佢諗多啲 token,難題答得好啲。
💰 但呢啲 token 你係要俾錢嘅
思考嗰段,照計 token、照食 context。
即係話一個三行嘅答案,背後可能燒咗幾千個你見唔到嘅 token。所以 reasoning 模型又慢又貴,唔係「免費叻咗」。
做幾百萬次,佢就學識咗「乜嘢諗法會通向正確答案」。
⚖️ 幾時值得?
值得:數學、寫 code、多步邏輯、規劃、debug⋯即係「有得驗證啱唔啱」嗰類。
唔值得:總結、改語氣、格式轉換、查資料、寫封 email。呢啲嘢冇一個「正確答案」俾佢驗證,佢諗耐啲都唔會好啲,你淨係俾多咗錢同等耐咗。
用 reasoning 模型寫一封客戶信,係買咗一啲你唔需要嘅嘢。
⚠️ 兩個最多人誤會嘅位:
一,你見到嗰段「思考」唔係佢真正嘅運算過程。
嗰段嘢一樣係生成出嚟嘅文字。佢讀落好似一個推理紀錄,但研究一路都指出:佢可以同實際導致個答案嘅計算唔一致。當佢係「解釋」可以,當佢係「審計紀錄」就危險。
二,諗多啲唔係一定好啲。 佢可以諗諗下推翻咗本身啱嘅第一直覺。呢個現象叫 overthinking,係真嘅。
🔗 同 Day 41 串埋睇,有個位好值得諗:
benchmark 量嘅,正正就係嗰啲答案驗證得到嘅題目⋯數學、程式。而 reasoning 模型就係專門喺呢類題目上面用 RL 練出嚟。
所以你會見到分數跳升,但日常用落覺得「好似冇咁誇」。兩樣都係真嘅⋯佢真係喺嗰類題目勁咗好多,而你日常做嘅嘢好多都唔屬於嗰類。
📌 Takeaway:reasoning 模型唔係「更聰明嘅模型」,係一個攞時間同金錢去換準確度嘅模型。條問題有冇客觀對錯,決定咗你換唔換得抵。