AI-101 Day 42:Diffusion
🎓 AI-101 | Day 42:Diffusion⋯AI 出圖點解同出字唔同
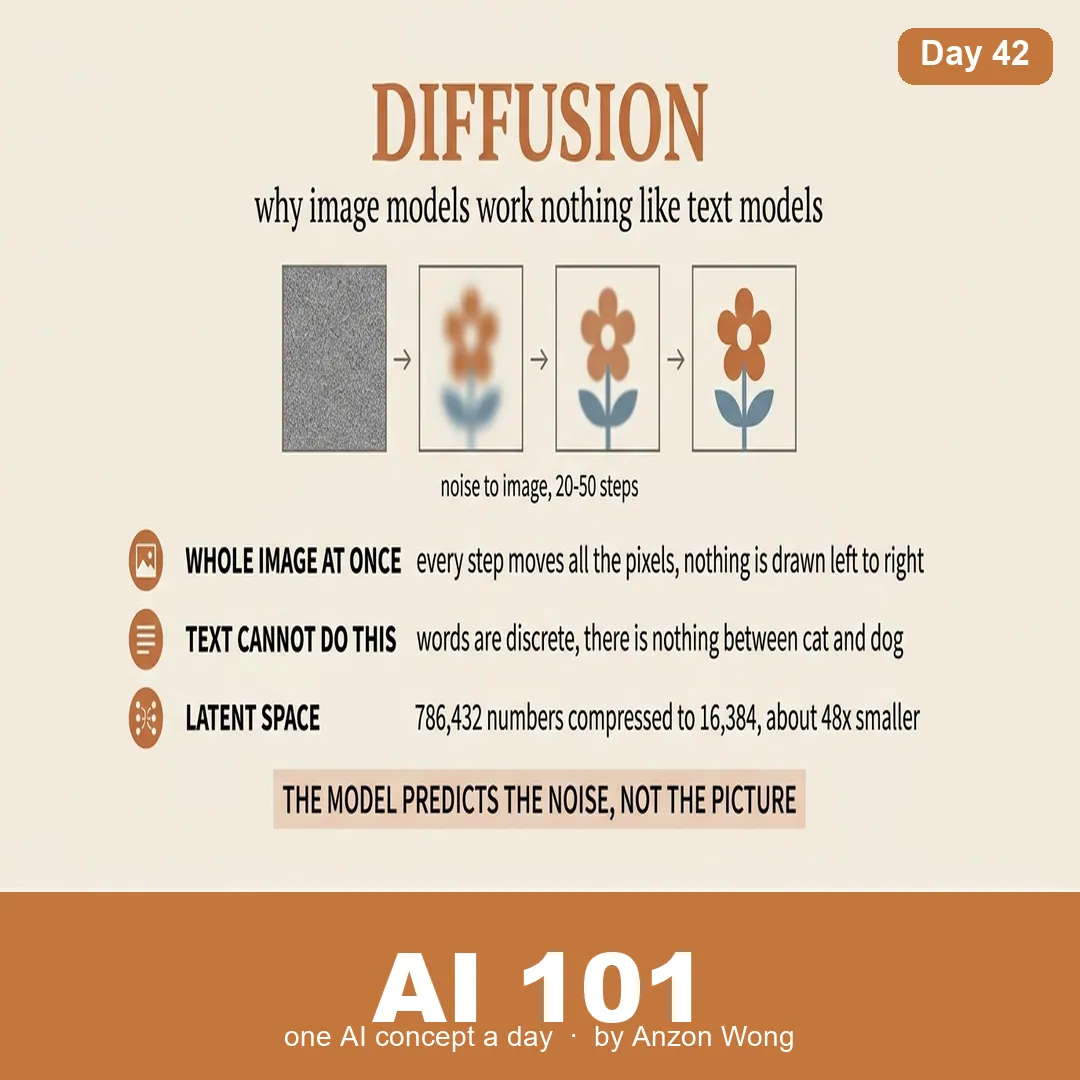
由 Day 32 講 attention 開始,我哋講嘅一直都係同一種機制:一個 token 一個 token 咁吐。左至右,每一個字都睇住前面所有字先決定。
出圖完全唔係咁。
🌫 出圖係由一嚿雜訊開始,慢慢「抹返乾淨」
Diffusion 個訓練過程,反過來諗最易明:
攞一張真相,加少少高斯雜訊。再加。再加。加到最後成張相變晒雪花,同隨機數字冇分別。
然後訓練個網絡做一件極之簡單嘅事:俾佢一張加咗雜訊嘅相,同埋話返俾佢知係第幾步,叫佢估「啱啱加咗落去嘅雜訊係咩樣」。個 loss 就係估出嚟嘅雜訊同真雜訊之間嘅平方差。就係咁多。
識咗估雜訊,出圖就係倒返轉行:由純粹隨機數字開始,每一步減走佢估到嘅雜訊,行 N 步。2020 年 DDPM 要行 1000 步,而家啲 sampler(DDIM、DPM-Solver 呢啲)20 到 50 步就得。
關鍵分別喺呢度:每一步都係成幅圖一齊郁,唔係逐格畫。
📝 咁點解文字唔用呢招?
因為文字係離散嘅。
一個像素可以係 137,可以係 138,你加 0.3 落去佢仲係一個有意義嘅像素。但你寫唔到「半個字」⋯「貓」同「狗」之間冇嘢。冇得逐少逐少加雜訊,個做法就唔成立。
(補充返:離散 diffusion 係有人做緊嘅研究方向,唔係做唔到⋯但主流文字模型今日仍然係逐個 token 吐。)
🗜 第二個關鍵:唔好喺像素度做
一張 512×512 彩色相 = 512 × 512 × 3 = 786,432 個數字。每步都要處理咁多嘢,行五十步,你部機頂唔順。
關鍵分別喺呢度:每一步都係成幅圖一齊郁,唔係逐格畫。
2022 年 Stable Diffusion 嗰篇論文(Latent Diffusion)做嘅事:先用一個 encoder 將張相壓成 64×64×4 = 16,384 個數字,喺呢個「潛空間」入面做 diffusion,做完先解返做像素。
細咗 48 倍。 呢個先係出圖由「要一部數據中心」變成「一張 consumer 顯示卡跑得郁」嘅轉捩點。
🎯 你條 prompt 點入到去?
文字經過一個 text encoder 變成向量,再用 cross-attention 餵入每一步嘅去噪過程⋯即係 Day 32 講嗰個 attention,只不過今次係「圖睇住文字」。
仲有一味叫 classifier-free guidance:每一步行兩次模型,一次俾佢你條 prompt,一次乜都唔俾,然後向住「有 prompt」嗰個方向推多啲。推幾多就係你見到嗰個 CFG / guidance scale。推太少就唔跟你講,推太犀利就出啲過曝、油炸咁嘅圖⋯唔係佢壞咗,係你叫佢推得太盡。
🧩 三樣值得記住:
- 🖼 出圖冇得「串流」⋯你見到文字模型一個字一個字咁出,但出圖係等,然後成張一次過出現。呢個唔係介面設計,係演算法本身:去到最後一步之前,幅圖係一嚿雜訊
- ✏️ 改圖同出圖係同一件事⋯唔由純雜訊開始,而係由你張真相加一半雜訊開始,再去噪,就係 img2img。你調嗰個 strength,調嘅就係加幾多雜訊落去
- 🔢 步數係買時間,唔係買質素⋯過咗某個點加步數幾乎冇分別。真正影響靚唔靚嘅係個模型同你條 prompt
📌 Takeaway:文字模型係一個字一個字砌出嚟;出圖模型係成幅嘢由雜訊入面慢慢浮返出嚟。兩樣嘢好唔同,所以佢哋壞嘅方式都唔同。