AI-101 Day 41:Evals / Benchmark
🎓 AI-101 | Day 41:Evals / Benchmark⋯個分數呃唔呃你
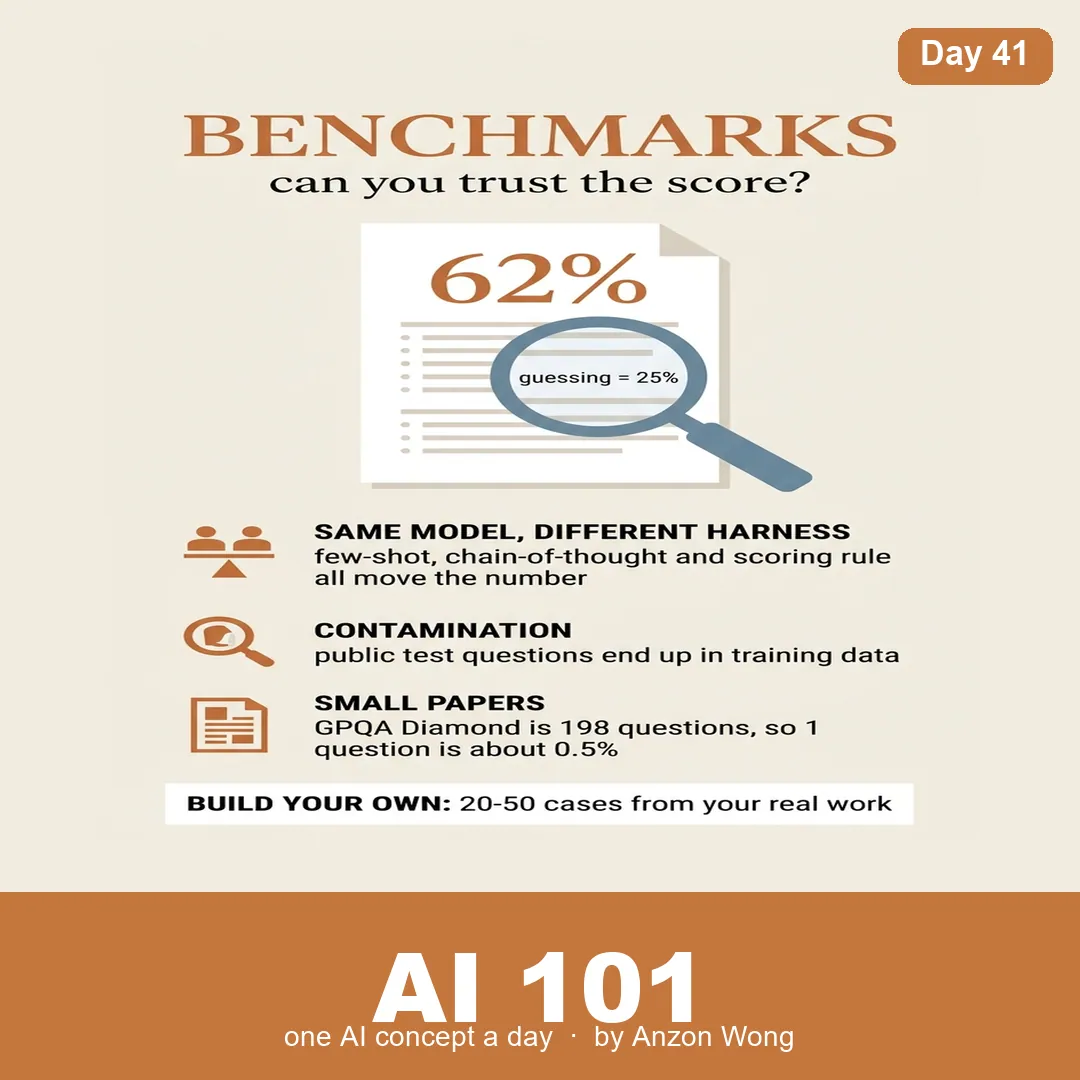
每次有新 model 出,第一樣見到嘅一定係嗰張 bar chart:MMLU 幾多分、GPQA 幾多分、SWE-bench 幾多分。今日講點解嗰個數字,唔可以照咁信。
📏 一個 benchmark 到底係乜?
一堆固定題目 + 一條自動評分規則。就係咁多。
MMLU:15,908 條多項選擇題,57 個科目,每題四個選項。即係話⋯亂咁㨂都有 25 分。你見到「62%」嗰陣,要記住個底唔係 0。
🔧 同一個 model,同一份卷,可以出唔同分數
呢個係最少人知嘅一點。個分數唔淨止睇個 model,仲睇你點考:
- Few-shot 定 zero-shot⋯題目前面俾唔俾幾個示範?5-shot 同 0-shot 可以差幾個百分點
- 俾唔俾佢諗(chain-of-thought)⋯Day 34 講過,准佢先寫推理過程,數學題分數可以跳一大截
- 點評分⋯係比較四個選項嘅 log-likelihood(睇邊個字最順),定係真係叫佢生成答案再 parse?兩種計法出嚟嘅唔係同一個數
所以兩間公司報同一個 model 唔同分數,通常唔係邊個講大話,係兩套 harness。冇講清楚點考嘅分數,等於冇單位嘅數字。
🦠 第二個問題:污染(contamination)
benchmark 題目係公開喺網上嘅。training data 係喺網上爬返嚟嘅。
你估下會發生咩事。
如果題目連答案已經喺訓練資料入面,個分數量緊嘅就唔係推理,係記性。呢個唔係陰謀論,係公認嘅工程難題⋯所以先會有 n-gram 重疊檢查、canary string 呢啲手段,而 GPQA 特登設計成「Google 唔到」嘅題目。
順帶一提:MMLU 本身後來被審計出有一批題目答案標錯咗。
順帶一提:MMLU 本身後來被審計出有一批題目答案標錯咗。即係就算冇污染,個滿分本身都唔係 100。
🔬 第三個問題:啲卷細過你想像
GPQA Diamond 得 198 條題。
即係話:一題 ≈ 0.5 個百分點。你見到「高咗 1.5 分」,實際上係多啱咗三條題。放喺 bar chart 上面睇落好似一級跳,統計上可能係噪音。
仲有啲數字係「pass@k」或者「maj@32」⋯即係俾佢答 32 次,take 大多數。呢個同「佢答一次嘅表現」係兩件事,但擺埋同一張圖上面睇落一樣。
🧭 咁點算?
benchmark 唔係冇用⋯佢係業界唯一可以互相比較嘅共同尺。但佢量嘅係「呢個 model 喺呢份卷嘅表現」,唔係「佢做唔做到我份工」。
SWE-bench 量嘅係修 Python repo 嘅真實 GitHub issue。你係建築師,佢同你嘅相關度有幾高?可能有,但唔係直接。
三樣值得記住:
• 📐 睇分數之前先問點考⋯few-shot?CoT?幾多條題?廠商自己揀嘅 benchmark?
• 🧪 自己砌一份卷⋯揀 20 到 50 個你日常真係要做嘅 case,寫清楚點先算 pass,每次換 model 就跑一次。呢個係唯一一個關於你嘅分數
• 📉 分數飽和咗就換卷⋯MMLU 而家逼近上限,所以先會有 GPQA、SWE-bench、ARC-AGI 呢啲更難嘅出現。卷變難唔代表 model 變差
📌 Takeaway:benchmark 係一份卷,唔係一個保證。真正預測到你結果嘅,係你自己嗰二十個 case。