9 月 11 號,有人將一個 744 billion 參數嘅模型放咗上網
9 月 11 號,有人將一個 744 billion 參數嘅模型放咗上網。冇發布會,冇 blog post,冇 keynote,連 paper 都係四日之後先出。
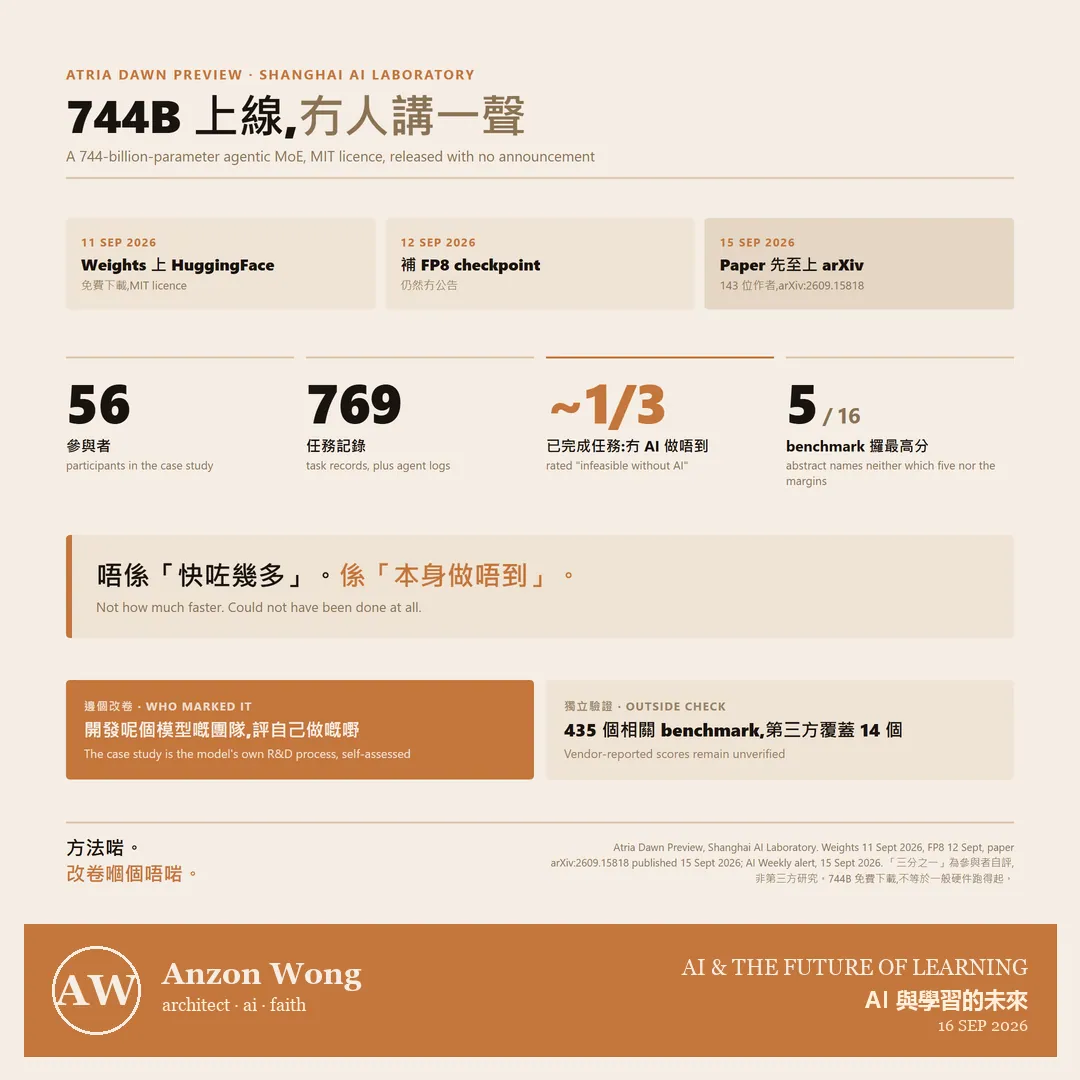
放模型嗰個係上海人工智能實驗室。個模型叫 Atria Dawn Preview,MIT licence,即係你下載到、改得、攞嚟做生意都得。11 號 weights 上咗 HuggingFace,12 號補埋 FP8 版本,15 號先至將 paper 擺上 arXiv。
143 個作者。個題目一啲都唔客氣:《Atria Dawn: The Dawn of Agentic Superintelligence》。
但令我一路睇落去嘅,唔係個題目,係佢哋點量度自己。
篇 paper 有一段,係攞佢哋開發呢個模型嘅過程本身嚟做研究對象:56 個參與者,769 個任務記錄,連埋 agent 嘅 log。跟住叫返班參與者評估自己做完嘅嘢。結果:大約三分之一已完成嘅任務,佢哋自己話,冇 AI 係根本做唔到。
唔係「快咗幾多」。係「本身做唔到」。
我覺得值得抄嘅,唔係個模型,係呢個做法。
結果:大約三分之一已完成嘅任務,佢哋自己話,冇 AI 係根本做唔到。
我教 AI 嗰陣成日俾人問同一條問題:點知佢有冇用?最順口嘅答案係「快咗」。但「快咗」講唔贏一個本身就唔想改嘅人,因為佢隨時可以話,你係本身做得慢啫。「呢件事冇佢做唔到」就唔同,嗰條係講得出口嘅界線,亦都係你落 budget 之前應該答得出嘅嘢。
要打嘅折照講:
・三分之一嗰個數字,係開發呢個模型嘅團隊評自己做嘅嘢。唔係第三方研究,係自己改自己份卷。
・佢哋話 16 個 benchmark 有 5 個攞到最高分,但 abstract 冇寫明邊 5 個,亦冇寫贏幾多。
・獨立驗證暫時冇。有個統計話,相關嘅 435 個 benchmark,第三方覆蓋到嘅得 14 個。
・744B 免費下載,同你用得起,係兩回事。呢個 size 唔係一部機跑得郁。
・個題目寫住 superintelligence,底下撐住嘅證據係 56 個人嘅工作紀錄。兩樣嘢唔同級數。
方法啱,改卷嗰個唔啱。呢兩件事可以同時成立。
所以我想問嘅係:如果而家叫你數返轉頭,過去一個月,你有幾多件已經做完嘅事,係冇 AI 根本做唔到?