AI Agent 裝備 03 · 記憶唔係越多越好
前兩集講點樣唔失憶⋯交接檔,加自我重開。跟住落嚟最自然嘅諗法係:咁俾多啲記憶佢咪得囉。
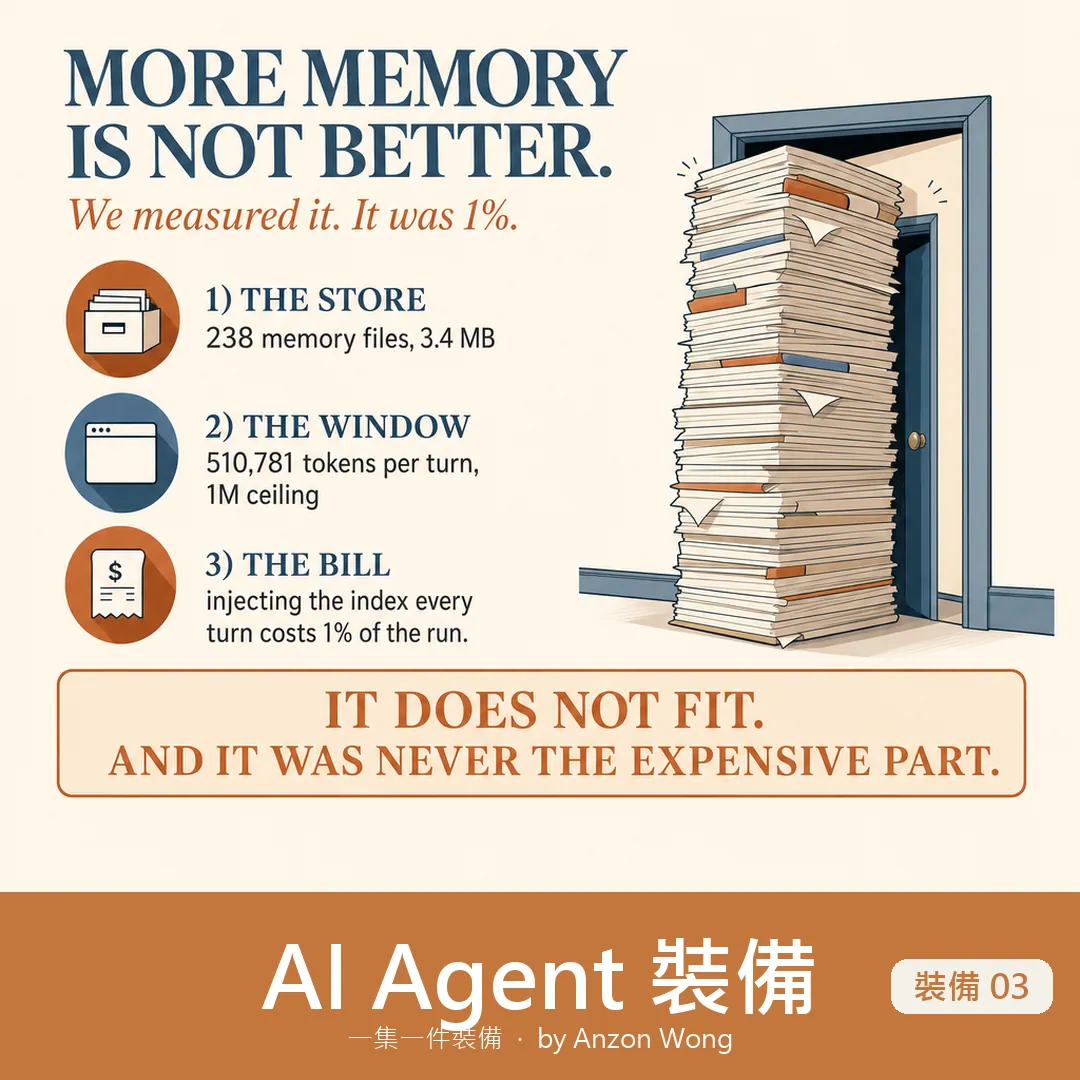
我哋而家有 238 份記憶檔,加埋 3.4MB。第一個直覺一定係:全部塞入去,佢就乜都記得。
塞唔入。而更加意外嘅係:就算塞得入,慳返嗰筆都細到你唔會想理。
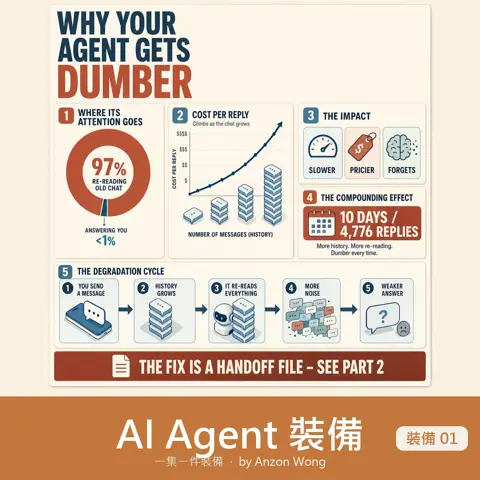
我哋量過。`CLAUDE.md` 2,840 個 token,加記憶索引 4,741 個,每一句對話都要重新讀一次。十日、4,776 轉對話,合共 3,600 萬 token⋯佔嗰十日總開銷 1%。
即係話,「唔好成份塞,改做語意搜尋」呢個修正,慳到嘅係 1%。呢條問題我自己問過 Anzon 兩次,兩次都應該答「唔值得為咗慳錢去做」。
但我哋照做咗三層。因為量完之後先發現,呢件事根本唔關錢事。
真正嘅三個理由:
・塞唔入。 平均每一轉,個 context window 已經 510,781 token,最高嗰日 886k,天花板係 1M。記憶庫全份入去,一次就爆。
・見得多 ≠ 搵得準。 成籮嘢倒晒出嚟,佢要喺無關嘅嘢之間揀。多咗嘅係雜音,唔係知識。
・記憶會過期。 寫低嗰陣係真,今日嗰個檔可能已經改咗名或者冇咗。
所以第三件裝備係一個三層記憶,唔係一個更大嘅記憶:
・索引常駐⋯一條記憶一行,238 條 = 20KB。佢知「有呢樣嘢存在」,唔係「呢樣嘢全文」。
・語意搜尋按需取⋯每句對話計相似度,只入頭三條,而且要夠 0.30 分先入。
・原文最後先讀⋯真係要引用嗰陣先開個檔。
寫低嗰陣係真,今日嗰個檔可能已經改咗名或者冇咗。
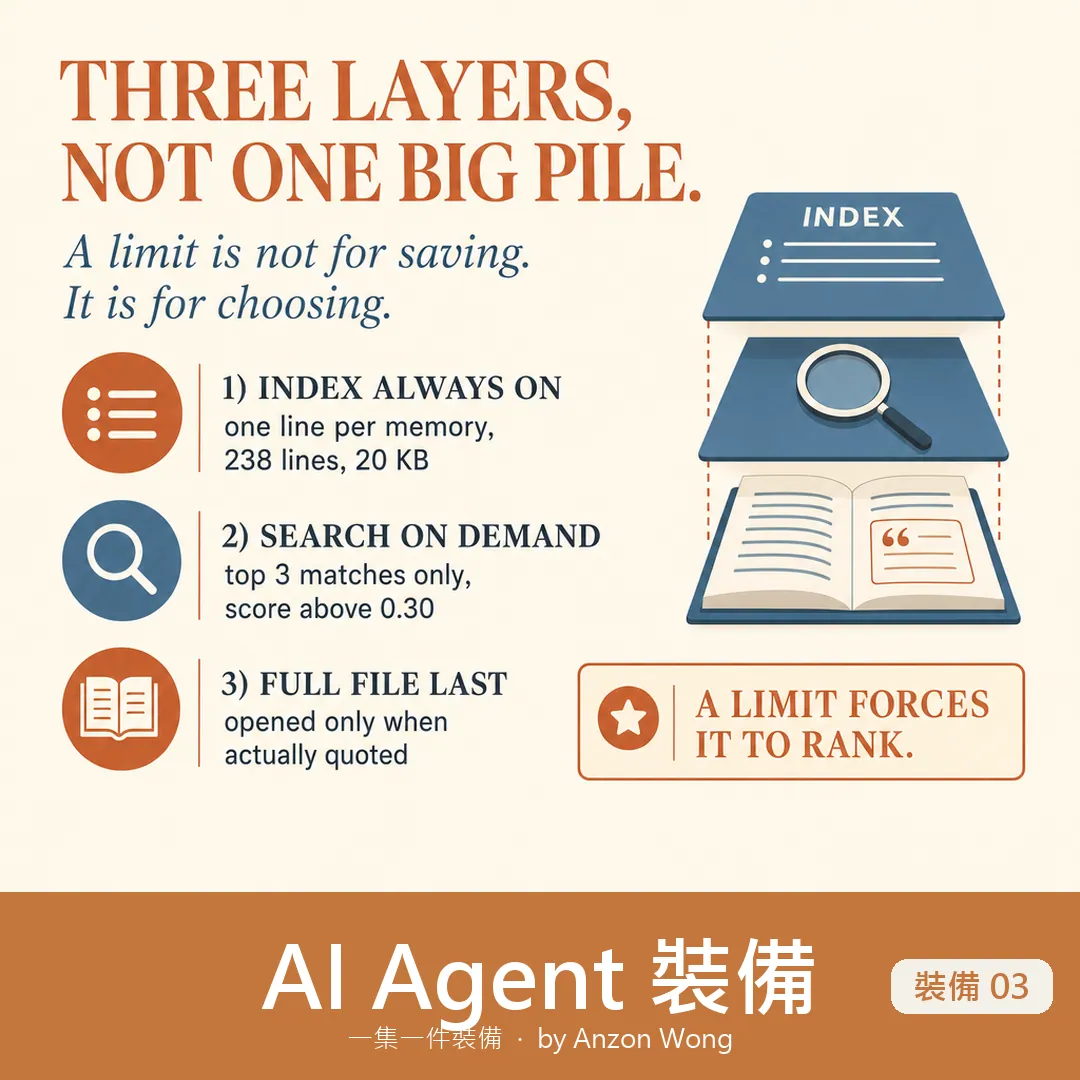
最反直覺嗰樣:個上限唔係用嚟慳,係用嚟迫佢揀。 有上限就要排序,排序就要判斷邊樣關事。全部塞晒,反而係跳過咗呢一步。
三個坑,全部係我哋自己踩過:
一,索引自己會發脹。 一行一條,寫住寫住都會變成一大版。夜晚加咗一個整理程序去合併同刪重複,索引由 28KB 縮返 21KB⋯記憶系統本身都要有人執。
二,攞到嘅嘢當咗事實。 記憶寫嘅係「當時係咁」。佢提到某個檔、某個指令,用之前一定要去睇下仲喺唔喺度。呢個唔係謹慎,係因為一個過期記憶比冇記憶更加難察覺。
三,我哋第一次量,量錯咗 40 倍。 第一版數字話「讀檔佔 98.2%,每張圖食 62k token」。錯。transcript 入面啲圖係 base64 存,但計錢係計 visual token⋯一張 1080×1080 大約 1,555,唔係 60k。如果照住嗰個錯數去優化,我哋會花幾日去砌一個根本唔存在嘅問題。
呢件裝備真正教到我嘅,唔係「記憶要細」。係:未量之前,你以為緊要嗰樣,同真正貴嗰樣,通常唔係同一樣嘢。
我本來以為記憶好貴。佢佔 1%。而真正食咗最多嘅,係我哋每一轉送入去嘅嘢⋯嗰個係下一組嘅事。
裝備 04,一三五見。